 ChatGPT
 Claude
 Perplexity
 Gemini
Pense em um cadastro de crédito comum. O cliente envia a identidade, um comprovante de residência e um holerite. Do outro lado, alguém abre cada arquivo, procura o nome, o CPF, o endereço, a renda, digita tudo no sistema e confere se as informações batem entre si. Multiplique isso por milhares de pedidos por mês e o resultado é fila, erro de digitação, cliente esperando e custo crescendo junto com o volume. A extração de dados de documentos existe para tirar esse trabalho do caminho. Este texto mostra o que é extração de dados, como funciona um fluxo completo da foto até o dado validado, o que muda quando entra a inteligência artificial e como implantar a automação sem abrir mão do controle.
O que é extração de dados de documentos
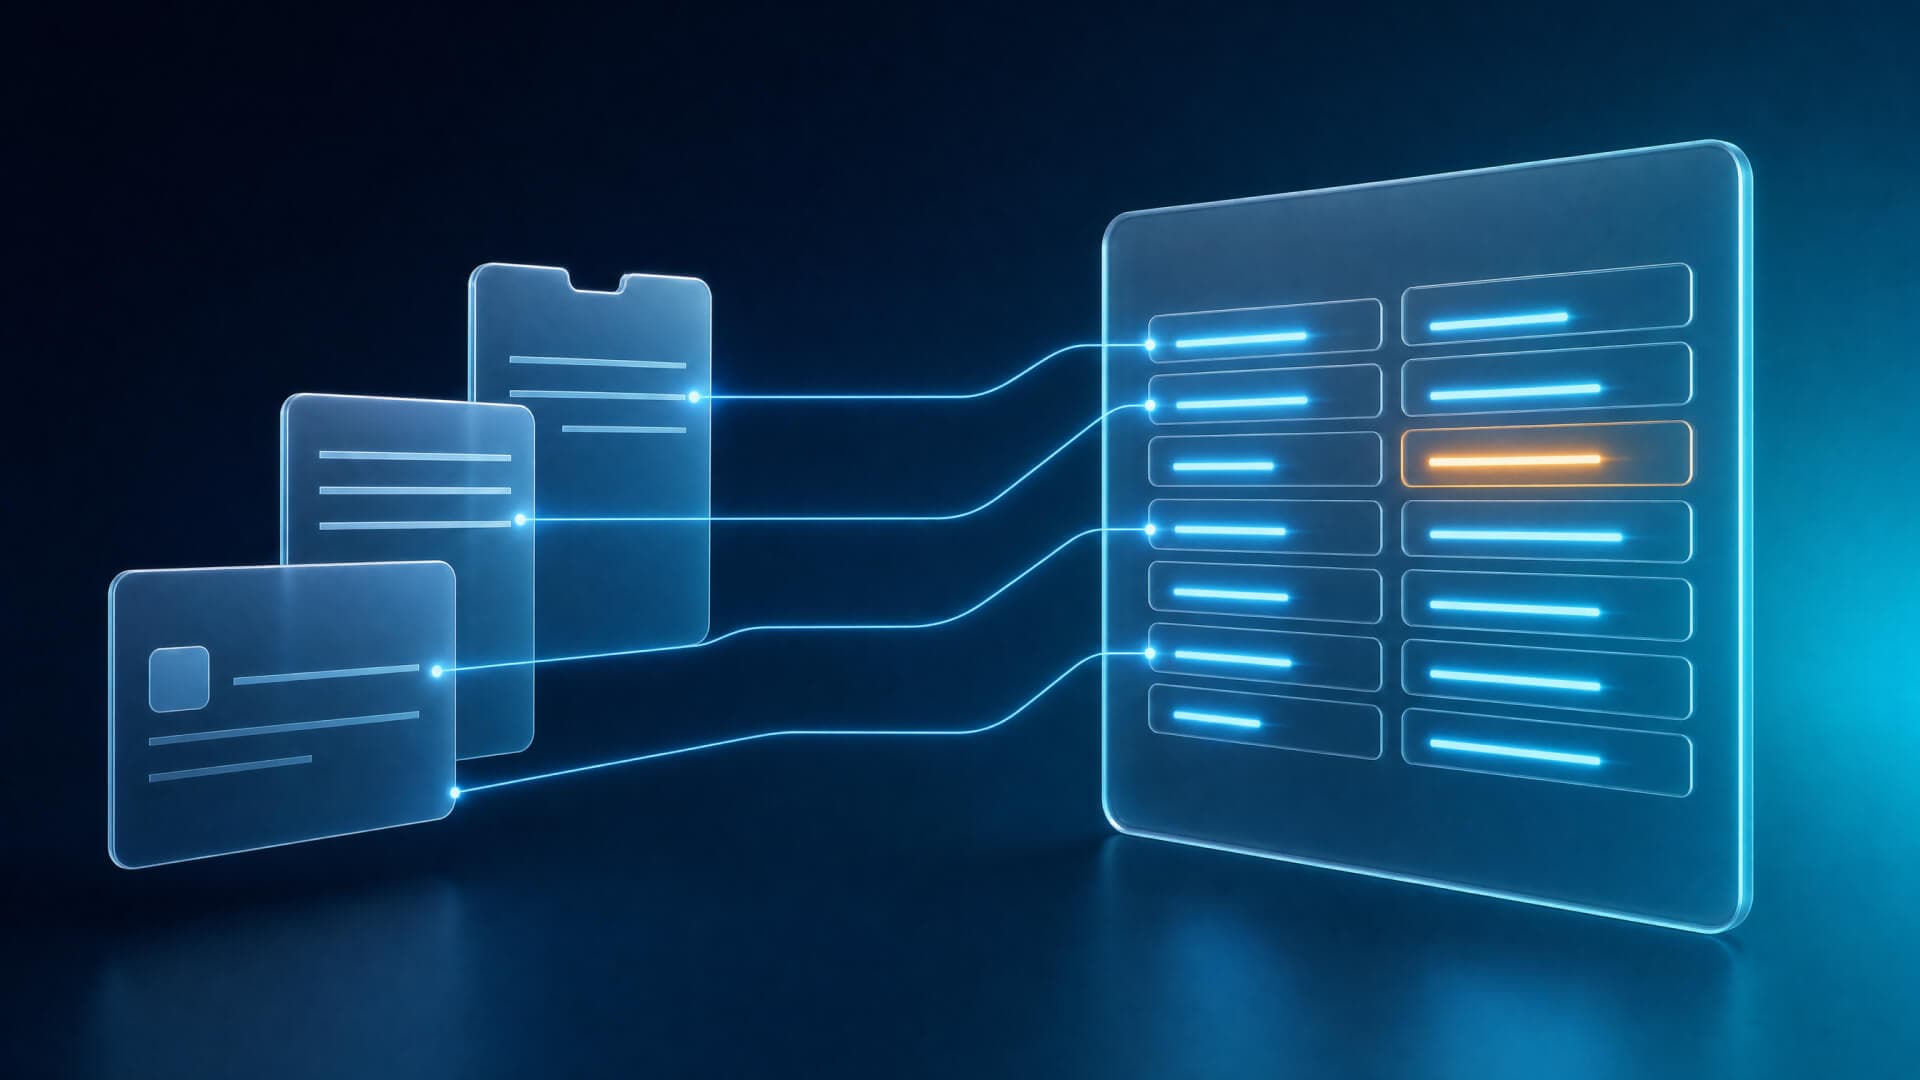
Extração de dados de documentos é o processo de identificar, capturar e organizar automaticamente as informações contidas em um documento, como nome, número de inscrição, datas, endereço e valores, e entregá-las em formato estruturado para o sistema que vai usá-las.
A tecnologia de base é o reconhecimento óptico de caracteres, o OCR, que converte a imagem em texto. O funcionamento dele, etapa por etapa, está explicado em OCR: o que é, como funciona e como as empresas usam na leitura de documentos. A extração vai um passo além: não basta saber que existe a palavra "Maria" na imagem, é preciso saber que ela é o primeiro nome da titular, que o número ao lado é o CPF e que a data mais abaixo é a de nascimento, e não a de emissão.
Quando esse processo ganha classificação automática do documento, extração orientada por campos e validação dos dados, o mercado costuma chamá-lo de processamento inteligente de documentos.
Por que a digitação manual ainda custa caro
Muitas empresas já automatizaram quase toda a jornada digital e mantêm, no meio dela, uma etapa manual de conferência de documentos. Ela costuma ser invisível nos indicadores, mas pesa em quatro frentes.
Tempo. Cada documento digitado leva minutos. Em períodos de pico, como campanhas de crédito ou contratações em massa, a fila cresce mais rápido que a equipe.
Erro. Um dígito trocado no CPF, um número de endereço invertido ou uma data digitada no formato errado geram retrabalho, recusa indevida e, em alguns casos, cadastro com dado de outra pessoa.
Abandono. Quando o cliente precisa preencher à mão o que já enviou em foto, a chance de desistir no meio do caminho aumenta.
Custo que acompanha o volume. Na digitação manual, dobrar o número de cadastros significa quase dobrar a equipe de conferência. Com a extração automática, o custo por documento cai à medida que o volume sobe.
Os números que a Valid divulga para a leitura automática de documentos dão a dimensão desse ganho: redução de 98% no tempo de processamento em relação à digitação manual, de 80% nos erros de preenchimento e de 94% nos custos operacionais.
O fluxo de extração de dados, da foto ao campo validado
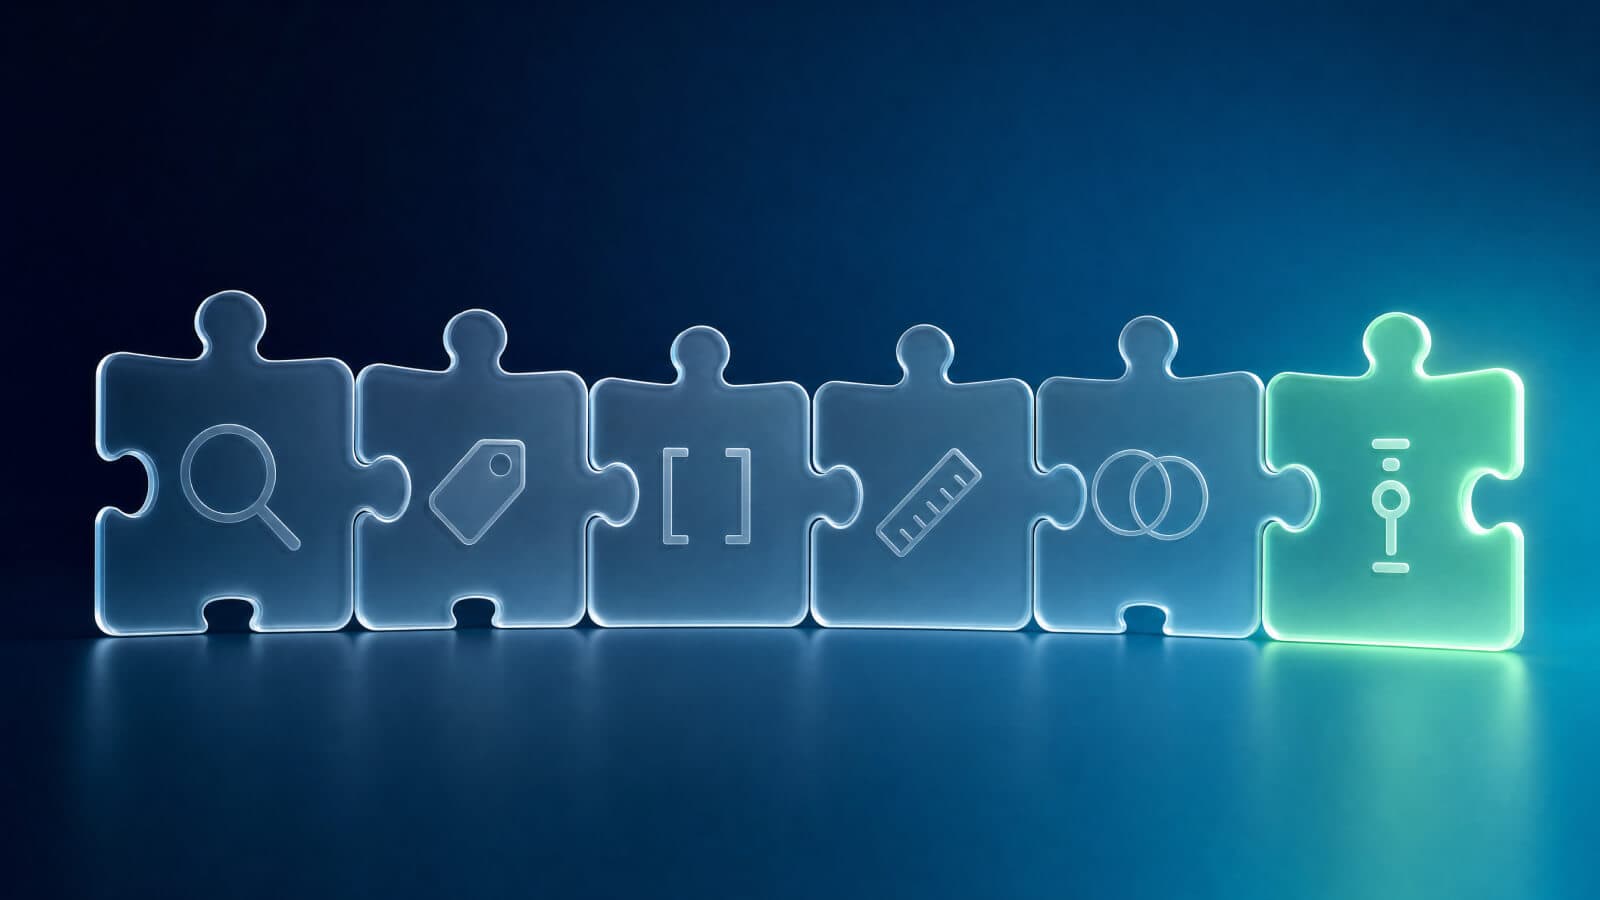
Um fluxo de extração bem desenhado vai além da leitura e passa por seis momentos. Cada um resolve um problema diferente, e pular qualquer um deles costuma aparecer depois, como retrabalho.
Captura com orientação
A extração começa antes do envio. O aplicativo ou a página orienta o enquadramento, avisa sobre reflexo e sombra e pede uma nova foto quando a imagem não tem qualidade. Uma captura bem orientada reduz a quantidade de documentos que chegam ilegíveis ao processamento.
Classificação do documento
O sistema identifica sozinho o que recebeu: um RG, uma CNH, a Carteira de Identidade Nacional, um comprovante de residência e um contrato social. O usuário não precisa escolher o tipo em uma lista, e o modelo de extração certo é aplicado em seguida. Na leitura automática citada acima, essa identificação tem mais de 98% de precisão e cobre mais de trinta tipos de documento brasileiros.
Extração por campos
Com o tipo definido, o sistema localiza cada campo de interesse e captura o conteúdo. Em documentos de identidade, isso significa nome, filiação, número do documento, CPF, data de nascimento e órgão emissor. Em um comprovante de residência, titular, endereço completo e data de emissão.
Normalização
O dado extraído é padronizado: datas no mesmo formato, CPF sem pontos, nomes sem espaços duplicados, siglas de estado conferidas. Parece detalhe, mas é o que permite que o sistema de destino receba o dado sem tratamento adicional.
Validação cruzada
É o momento em que o dado lido vira dado confiável. O sistema confere o dígito verificador do CPF, cruza o nome do comprovante com o do documento de identidade, verifica se a data do comprovante está dentro do prazo aceito pela política da empresa e compara as informações com o que o cliente digitou no formulário.
Decisão por nível de confiança
Cada campo extraído vem acompanhado de um percentual de confiança, e a empresa define o que fazer com ele. Na Plataforma de Segurança Digital da Valid, a régua sugerida é: de 95% a 100%, aceite automático; de 85% a 94%, revisão opcional; de 70% a 84%, revisão manual recomendada; abaixo de 70%, nova foto do usuário. É essa régua que permite automatizar a maior parte do volume e mandar para revisão humana só o que realmente precisa.
Quer medir quanto do seu cadastro pode seguir sem digitação? Fale com um especialista da Valid.
Processamento inteligente de documentos: o que a IA muda
As primeiras ferramentas de extração trabalhavam com modelos fixos. Alguém desenhava, para cada documento, a área exata de cada campo, e o sistema lia aquele retângulo. Funcionava bem com formulários padronizados e mal com o resto.
O problema é que boa parte dos documentos de uma operação real não tem layout único. O RG muda de estado para estado. O comprovante de residência pode ser uma conta de luz, de água, de telefone ou um extrato bancário, cada um de uma empresa diferente. O holerite depende do sistema de folha de pagamento de cada empregador.
A inteligência artificial resolve essa variação de outra forma. Em vez de procurar o campo em uma posição fixa, os modelos aprendem a reconhecer o significado da informação pelo contexto: o rótulo ao lado, o formato do conteúdo, a posição relativa a outros elementos. Com isso, o sistema consegue extrair o endereço de uma conta de luz que nunca viu antes, porque entende o que é um endereço, e não só onde ele costuma estar.
Esse avanço também melhora o tratamento de imagens ruins. Fotos tiradas em ângulo, com pouca luz ou com parte do documento coberta pelo dedo deixam de ser recusa automática e passam a ser lidas com um nível de confiança menor, que a régua de decisão trata.
Que dados extrair de cada tipo de documento
Cada documento cumpre um papel diferente no cadastro, e saber o que extrair de cada um evita capturar dado demais ou de menos.
Documentos de identificação. RG, CIN, CNH, passaporte e carteiras profissionais fornecem os dados que identificam a pessoa: nome completo, filiação, CPF, data de nascimento, número e órgão emissor do documento. São a base de qualquer verificação de identidade.
Comprovante de residência. Titular, endereço completo e data de emissão. Quando o titular da conta não é o próprio cliente, a política da empresa define se o documento é aceito e que comprovação adicional se pede.
Comprovantes de renda. Holerite, declaração de imposto e extrato. A extração foca em fonte pagadora, valor e período de referência, dados que alimentam a política de crédito.
Documentos de empresa. Contrato social, cartão CNPJ e documentos dos sócios. A extração identifica razão social, quadro societário, poderes de representação e endereço, informações essenciais para o processo de KYC e KYB.
Certidões. Nascimento, casamento e óbito trazem dados de estado civil e de vínculo familiar, usados em seguros, previdência e processos de herança.
Uma regra vale para todos: extrair só o que o processo realmente usa. Capturar campos que ninguém consulta aumenta o volume de dado pessoal guardado sem trazer benefício nenhum, o contrário do que pede a LGPD.
Do dado extraído ao dado confiável
A extração responde a uma pergunta: o que está escrito no documento. Ela não responde se o documento é verdadeiro nem se pertence à pessoa que o enviou. Um documento adulterado, com a data alterada ou a foto trocada, pode ter cada campo extraído com confiança alta.
Por isso, a extração é a primeira camada de um processo maior. A documentoscopia confere se o documento segue o padrão oficial de emissão e procura sinais de adulteração, tema detalhado em documentoscopia: o que é e como a tecnologia identifica documentos falsos. A verificação biométrica confirma que o rosto de quem enviou corresponde ao titular. O bureau traz situação cadastral e sinais de risco do CPF ou do CNPJ.
Para algumas jornadas, a melhor extração é a que nem precisa acontecer. Quando a identidade pode ser confirmada direto em bases de referência, a empresa dispensa a foto do documento, como mostra o texto sobre onboarding docless.
A confiança não nasce de uma tecnologia isolada. Ela nasce da integração entre camadas de verificação, combinadas conforme o risco de cada jornada. Na Plataforma de Segurança Digital da Valid, essa combinação é montada no orquestrador de produtos, totalmente no-code: a extração preenche, a documentoscopia confere, a biometria confirma a pessoa e o resultado segue para a decisão.
Como escolher uma ferramenta de extração de dados
Na hora de avaliar fornecedores, as demonstrações costumam usar imagens perfeitas. A escolha certa depende de perguntas que mostram o comportamento da ferramenta no dia a dia da sua operação.
Ela cobre os documentos que você recebe? Liste os tipos que chegam à sua base, inclusive os menos comuns, e confira um por um. Documentos brasileiros têm particularidades que soluções pensadas para outros mercados nem sempre tratam bem.
Ela informa a confiança de cada campo? Sem esse número, você não consegue separar o que segue direto do que precisa de revisão, e a automação vira tudo ou nada.
Quanto tempo leva a resposta? Em jornadas digitais, o cliente espera na tela. A leitura automática da Plataforma devolve o resultado em menos de 5 segundos por documento.
Como o dado chega ao seu sistema? O ideal é uma API que recebe a imagem e devolve o resultado estruturado, sem regra extra para interpretar a resposta.
O que acontece com a imagem depois? Pergunte por quanto tempo ela fica armazenada, onde e para quê. Na leitura automática da Plataforma, as imagens não são guardadas de forma permanente e o tratamento segue a LGPD.
Ela conversa com as outras camadas? A extração isolada resolve a digitação, mas deixa a fraude passar. Avalie se a ferramenta se integra à verificação do documento, da pessoa e do histórico, sem projetos paralelos.
Como implantar a extração automática sem travar a operação
A troca da digitação pela extração automática funciona melhor quando acontece em etapas, com números na mão a cada passo.
Comece por uma amostra real. Separe algumas centenas de documentos que a sua operação recebeu nos últimos meses, com as fotos ruins incluídas, e rode a extração sobre eles. É o retrato mais honesto do que esperar.
Meça a taxa de aprovação automática. O indicador mais importante é a parcela de documentos que passa sem nenhuma intervenção humana. Ele mostra o ganho real e orienta o tamanho da equipe de revisão.
Mantenha a revisão humana para a zona cinzenta. Os campos com confiança intermediária vão para uma fila de conferência. Com o tempo, a análise dessa fila mostra onde a captura ou a régua podem melhorar.
Ajuste a régua ao risco. Um cadastro de baixo risco pode aceitar automaticamente uma faixa maior de confiança. Uma concessão de crédito alta pede régua mais rígida. A mesma ferramenta atende os dois casos com configurações diferentes.
Registre tudo. Cada documento processado, cada decisão automática e cada revisão humana precisam deixar rastro. Isso facilita auditoria, contestação e a evolução do próprio processo, como mostra o texto sobre compliance em identificação digital.
Do papel ao dado, com quem conhece o documento brasileiro
A extração de dados de documentos tira do caminho a etapa mais lenta e mais sujeita a erro de qualquer cadastro. Mas o ganho real aparece quando ela deixa de ser uma ferramenta isolada e passa a alimentar, com dado confiável, as camadas que confirmam o documento, a pessoa e o risco.
A Valid é emissora dos principais documentos oficiais do Brasil e conhece, de dentro, como cada um deles é construído. É essa origem que sustenta uma extração que entende o documento brasileiro em toda a sua variedade, e não só os caracteres impressos nele. Se o seu cadastro ainda depende de alguém digitando o que o cliente já enviou, converse com o time da Valid e veja como automatizar essa etapa na sua jornada.